KVキャッシュサイズを固定した定速生成LLM: AnchorMass Attention
長文LLMのKVキャッシュ肥大化を解決するため、Value外れ値の分離ブロック圧縮とエネルギー指標マージを導入したAnchorMass Attentionを開発。同条件のStandard-150Mとの対照実験により、256Kトークンでも総KVキャッシュ258.58MiBに固定しつつ、デコード速度や想起・言語モデリング性能維持の実測結果と代償・トレードオフを記録。
Intro
自己回帰型のTransformer言語モデルにおいて、系列長が伸びるにつれて避けて通れないのがKey-Value(KV)キャッシュのメモリ爆発です。
過去の全トークンに対するKeyとValueを無圧縮で保持する標準キャッシュ方式では、コンテキスト長 に比例してVRAM消費量とメモリアクセス負荷が増大します。例えば150Mクラスの小型モデルであっても、系列長が256K(約26万トークン)に達するとKVキャッシュ単体で10GBを超え、一般的なGPU環境ではあっという間にOOM(Out of Memory)を引き起こします。
このキャッシュサイズを一定の予算 以下に制限するアプローチとして、主に2つの流れが存在します。
- 間引き・破棄方式(StreamingLLM, H2O, SnapKV 等): 先頭のSinkトークンや注意スコアの高いトークンのみを残し、他を破棄する。 → 弱点: 予算を超えた過去の文脈が完全に消失するため、長距離に埋もれた固有情報を取りこぼす。
- マージ・統合方式(ToMe, DMC, CaM 等): 類似するトークン同士を重み付き平均などで統合する。 → 弱点: 固有名詞や数値といった局所的な重要表現が、周囲の圧倒的な背景表現に平均化されて埋没・鈍化してしまう。
そこで、このジレンマを解決するために2段階の圧縮機構を備えた注意機構 AnchorMass Attention を設計・実装しました。
Value空間における幾何学的な外れ値を単独スロットとして保護しつつ、背景群のみを加重平均して総質量を厳密に保存。さらにキャッシュ上限に達した際は、エネルギー指標に基づく段階的マージを行うことで、総KVキャッシュ容量を一定の上限(実測258.58 MiB)に完全に固定します。
本記事では、158.6Mパラメータで完全同条件の標準Transformer(Standard-150M)をゼロから事前学習・対照比較し、4Kから256Kトークンの実測ベンチマークを通じて得られた利得、そしてPrefill遅延などの明確な代償・トレードオフを包み隠さず客観的に記録します。
AnchorMass Attention の設計と仕組み
AnchorMass Attention を組み込んだ言語モデル AnchorMass-150M は、Pre-RMSNorm と SwiGLU FFN で構成される 14 層の Transformer であり、自己注意層を独自の圧縮アーキテクチャに置き換えています。
全体の処理フローは以下の4つの柱から成り立ちます。
flowchart TD
    Input["入力トークン列 X<br/>(Dynamic NTK RoPE)"] --> Split["Head 二分割<br/>Local 6H / Global 6H"]
    Split --> LocalPath["Local Path: 近傍注意<br/>幅 C=64 (直近64tok保持)"]
    Split --> GlobalPath["Global Path: 長期圧縮ストリーム<br/>先頭16tok (Sink) 保護"]
    GlobalPath --> Stage1["第1段階: 外れ値分離圧縮<br/>64tokを8グループに分割<br/>外れ値1tok + 背景7tok加重平均<br/>(総質量8を厳密保存)"]
    Stage1 --> Stage2{"キャッシュ上限判定<br/>Global > 8,192 slots?"}
    Stage2 -- "No (≤ 32K)" --> MassSDPA["質量バイアス Global Attention<br/>ロジットに +log(n) 加算"]
    Stage2 -- "Yes (> 32K)" --> AdaptiveMerge["第2段階: エネルギー指標マージ<br/>Sink・直近保護 / 最小和ペア統合"]
    AdaptiveMerge --> MassSDPA
    LocalPath --> Concat["Head 結合 & 出力射影"]
    MassSDPA --> Concat
1. Local / Global Head 分割と Dynamic NTK RoPE
各層の全 12 個の Attention Head を 6 個ずつ二分します。
- Local Heads (): 直近の文脈を詳細に捉えるため、チャンク幅 のスライディングウィンドウ注意を計算します。推論時は直近 64 トークンの KV キャッシュのみを保持し、それ以前は自動的に破棄します。
- Global Heads (): 長期の記憶ストリームを担います。文頭の安定化に必要な先頭 16 トークンを Attention Sink として別枠で無圧縮保持し、それ以降のトークン列を後述の2段階圧縮機構(上限 スロット)へ送ります。
デコード中の RoPE 基底固定
長文拡張には Dynamic NTK RoPE を採用しています。生成中に過去の Key と新規 Query の位相がずれる「位相不整合」を防ぐため、推論開始時にセッション参照長 をプロンプト長 に固定し、長さ の正弦・余弦テーブル(FP32)を事前生成します。これにより、デコード中に回転基底が変化することはありません。
2. 第1段階: Value 外れ値分離ブロック圧縮
Sink 以降のトークン列は、ブロック長 ごとに 8 個のサブグループ(各 8 トークン)へと分割されます。
各サブグループ(トークン 、初期質量 )において、以下の処理を行います。
- 類似度とノルム比の算出: サブグループ内の初期加重平均 Value ベクトルに対するコサイン類似度と、平均ノルム比を全 Global Head で算出します。
- 候補選択と発火判定:
方向乖離が最大となるトークン を唯一の分離候補とし、以下の条件で外れ値判定を行います。
- コサイン類似度 または 相対ノルム
- 背景平均と外れ値の出力:
- 発火時: 候補 を独立スロット(質量 1)として分離保護し、残る 7 トークンを加重平均して背景スロット(質量 7)とします。
- 非発火時: 8 トークンすべてを加重平均して背景スロット(質量 8)とし、外れ値スロットは無効(質量 0)とします。
- アンカー Key の採用: 背景スロットの Key ベクトルには、位相干渉を避けるため背景集合の末尾トークンの Key(アンカー)を採用します。
# 第1段階サブグループ圧縮のアルゴリズム骨子
# 入力: サブグループ内の Key kg [H, 8, D], Value vg [H, 8, D], 質量 ng [H, 8] (初期値 1)

v_init_mean = (vg * ng.unsqueeze(-1)).sum(dim=1, keepdim=True) / ng.sum(dim=1, keepdim=True)
sim_mean = cosine_similarity(vg, v_init_mean).mean(dim=0)
rel_norm = (vg.norm(dim=-1) / vg.norm(dim=-1).mean(dim=1, keepdim=True)).mean(dim=0)

minsim, i_star = sim_mean.min(dim=0)
emit = (minsim < 0.85) or (rel_norm.max(dim=0)[0] > 2.0)

if emit:
    bg_idx = [i for i in range(8) if i != i_star]
    k_ex, v_ex, n_ex = kg[:, i_star], vg[:, i_star], ng[:, i_star]
else:
    bg_idx = list(range(8))
    k_ex, v_ex, n_ex = zeros_like(kg[:, 0]), zeros_like(vg[:, 0]), zeros_like(ng[:, 0])

n_bg = ng[:, bg_idx].sum(dim=1)
v_bg = (vg[:, bg_idx] * ng[:, bg_idx].unsqueeze(-1)).sum(dim=1) / n_bg.unsqueeze(-1)
k_bg = kg[:, max(bg_idx)] # 背景末尾位置のKeyをアンカー採用ポイント: 外れ値フラグの有無にかかわらず、サブグループ内のトークン欠落は一切発生しません。総質量 が厳密に保存されます。
3. 質量バイアス近似付き Global Attention
複数トークンが1スロットに統合されると、注意機構の softmax 計算において重みが過小評価されてしまいます。
そこで、各スロット が包含する元トークン数(質量 )を反映させるため、注意ロジットに対数質量 を加算します。
Key が完全に一致しない実際のテキスト列において、この対数バイアス加算は、統合スロットの注意重みが単一トークン相当へ減衰することを防ぐ効果的な粗視化近似として機能します。
4. 第2段階: エネルギー指標に基づくキャッシュ上限管理
Global 圧縮キャッシュが上限 スロットを超過した際、以下の adaptive ポリシーでキャッシュを削減します。
- 保護領域の除外: 先頭 16 スロットの Sink 領域と、直近の スロット(直近 2,048 スロット)を再マージ対象から除外します。
- 最小エネルギー隣接ペアの選択: 中間スロット に対し、以下のエネルギー指標を計算します。 隣接するペア和 が小さい下位ペアを選択します。
- ペア統合: スコア比率で加重平均した Value ベクトルを求め、スコアが高い側の Key を採用して1スロットに統合。質量は両者の和()とします。
実験セットアップ
AnchorMass の効果を厳密に検証するため、同一のベースモデルから完全に同一条件で学習させた対照モデルを用意しました。
モデル仕様とハードウェア環境
両モデルは語彙数 28,000、層数 14、隠れ層次元 768、FFN 次元 2,560、ヘッド数 12 で完全に一致しており、総パラメータ数はともに 158,635,776(158.6M) です。
| 項目 | 標準 Transformer (Standard-150M) | AnchorMass (AnchorMass-150M) |
|---|---|---|
| 総パラメータ数 | 158,635,776 | 158,635,776 |
| 層数 / 隠れ層 / FFN | 14層 / 768 / 2,560 (SwiGLU) | 14層 / 768 / 2,560 (SwiGLU) |
| Attention / KV Heads | 12 / 12 (Full Causal SDPA) | 12 / 12 (Local 6 + Global 6) |
| 位置埋め込み | Dynamic NTK RoPE () | Dynamic NTK RoPE () |
| 内部ブロック圧縮 | なし(全トークン保持) | チャンク幅64、8グループ、外れ値閾値0.85 |
| KV キャッシュ上限 | 制限なし(系列長 に比例) | Global圧縮上限 スロット +別枠固定(Sink 16・Local 64・端数最大48) |
- 基礎事前学習: NVIDIA RTX A5500(VRAM 24.0 GiB)
- 追加学習・8GB検証: NVIDIA GeForce RTX 4060 Ti(VRAM 8.0 GiB)
- 超長文評価ベンチマーク: NVIDIA RTX 6000 Ada Generation(VRAM 48.0 GiB)
3段階の学習パイプライン
評価用の未見コーパス val.bin(約 100 万トークン)はすべての学習データと厳密に分離しています。
flowchart TD
    S1["Stage 1: 1K 基礎事前学習<br/>3.0B tokens / 45,776 steps [RTX A5500]"] --> S2["Stage 2: 4K 系列長拡張 Warmup<br/>16.4M tokens / 2,000 steps (seed=42 完全同期) [RTX 4060 Ti]"]
    S2 --> S3a["Stage 3a: 長文カリキュラム SFT v2<br/>8K → 16K → 32K (長文想起・PPL評価)"]
    S2 --> S3b["Stage 3b: 短文 Chat SFT<br/>Japanese Alpaca 8,000件 (対話・JCQA評価)"]
特に Stage 2 では、乱数シード 42 のデータローダーにより、両モデルへ投入されるバッチ順序・トークン列を完全に同期させています。
実測ベンチマークと結果
1. KVキャッシュ容量・ピークVRAM・推論スループット
RTX 6000 Ada(48GB)環境において、4K から 256K トークンまでの推論プロファイルを実測した結果は以下の通りです。
| 系列長 | Standard-150M 総KV (Peak VRAM) | AnchorMass-150M 総KV (Peak VRAM) | Prefill 時間中央値 (Standard vs AM) | デコード速度中央値 (Standard vs AM) |
|---|---|---|---|---|
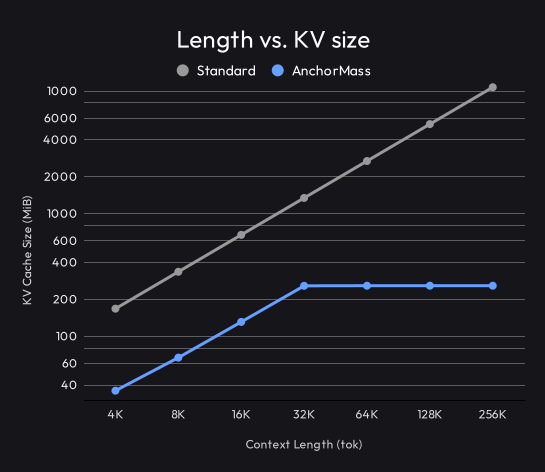
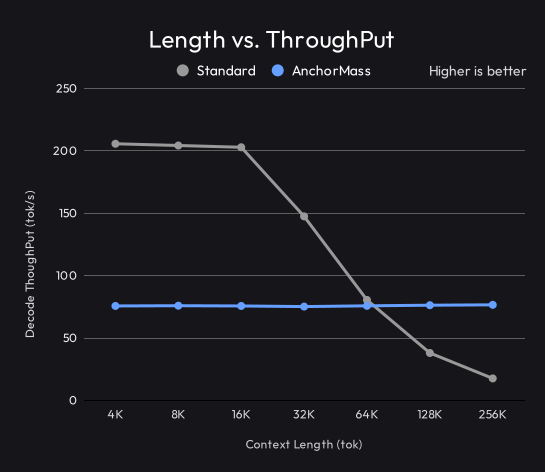
| 4,096 | 168 MiB (0.91 GiB) | 36 MiB (1.04 GiB) | 0.01 s vs 0.12 s | 205.7 vs 75.7 tok/s |
| 8,192 | 336 MiB (1.22 GiB) | 67 MiB (0.93 GiB) | 0.03 s vs 0.24 s | 204.3 vs 75.9 tok/s |
| 16,384 | 672 MiB (1.83 GiB) | 131 MiB (1.24 GiB) | 0.07 s vs 0.51 s | 202.9 vs 75.7 tok/s |
| 32,768 | 1,344 MiB (3.06 GiB) | 258 MiB (1.87 GiB) | 0.23 s vs 1.19 s | 147.5 vs 75.2 tok/s |
| 65,536 | 2,689 MiB (5.51 GiB) | 259 MiB (2.32 GiB) | 0.78 s vs 6.26 s | 80.5 vs 75.8 tok/s |
| 131,072 | 5,377 MiB (10.42 GiB) | 259 MiB (3.20 GiB) | 2.73 s vs 16.42 s | 38.0 vs 76.3 tok/s |
| 262,144 | 10,752 MiB (20.23 GiB) | 259 MiB (4.95 GiB) | 10.18 s vs 36.59 s | 17.6 vs 76.6 tok/s |
実測結果からわかること
- 総 KV キャッシュ容量が一定の上限値に固定される: Standard-150M は系列長に比例して線形増加し、256K では 10.75 GiB(10,752 MiB)まで膨れ上がります。 これに対し AnchorMass-150M は、Global 圧縮上限 スロットと別枠固定バッファ(Sink 16、Local 64、端数 48)により、32K 以降の総 KV キャッシュ容量を 実測 258.58 MiB(純粋 BF16 構成時 173.27 MiB)に厳密固定 できました。
- デコード速度が超長文でも一切低下しない: Standard-150M のデコード速度は長文になるほど低下し、256K では 17.6 tok/s まで落ち込みます。 一方 AnchorMass-150M は、4K から 256K まで 毎秒 75.2〜76.6 トークンと完全にフラットな速度を維持 しています。128K および 256K の超長文領域では、デコード速度が Standard を逆転(4.3倍高速)しました。
注意(ピーク VRAM の挙動): 表1の Peak VRAM はプロセス全体の最大値です。AnchorMass でも 32K の 1.87 GiB から 256K の 4.95 GiB へと増加していますが、これは全 14 層がそれぞれ系列長に応じた FP32 RoPE テーブル(256K 時で 1.75 GiB)を重複保持していること、および両モデルが GPU 上に同時常駐していたことによるものです。
2. 長系列 Perplexity 評価
未見コーパス val.bin から抽出した 10 個の固定アンカー位置に対し、同一の末尾 1,024 トークン(計 10,240 トークン)の言語モデリング性能(PPL)を測定しました。
| 系列長 (先行文脈) | Standard-150M PPL (Loss) | AnchorMass-150M PPL (Loss) | 観測 PPL 差 | AM 優位アンカー数 (検定) |
|---|---|---|---|---|
| 1,024 (先行 0) | 26.49 (3.277) | 36.91 (3.609) | +10.42 (Standard優位) | 0 / 10 勝 () |
| 2,048 (先行 1K) | 22.19 (3.100) | 17.95 (2.887) | -4.24 (AnchorMass優位) | 9 / 10 勝 () |
| 4,096 (先行 3K) | 21.67 (3.076) | 18.99 (2.944) | -2.68 (AnchorMass優位) | 9 / 10 勝 () |
| 8,192 (先行 7K) | 28.32 (3.344) | 21.47 (3.067) | -6.85 (AnchorMass優位) | 9 / 10 勝 () |
| 16,384 (先行 15K) | 50.03 (3.913) | 25.61 (3.243) | -24.43 (AnchorMass優位) | 10 / 10 勝 () |
| 32,768 (先行 31K) | 81.08 (4.395) | 34.17 (3.531) | -46.91 (AnchorMass優位) | 10 / 10 勝 () |
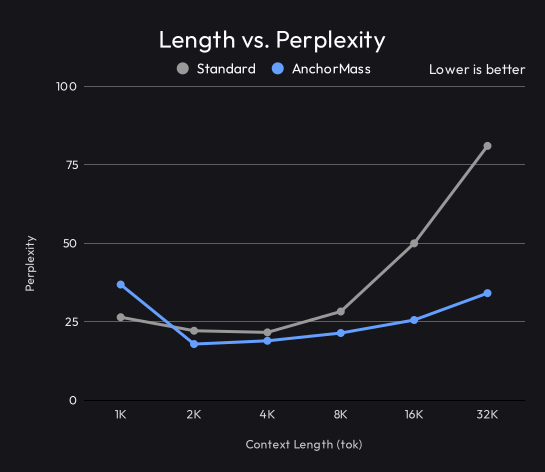
先行文脈のない 1,024 トークンでは無圧縮の Standard-150M が優位でしたが、先行文脈が付与される 2K から 32K の全領域において AnchorMass-150M の方が有意に低い PPL を記録 しました(全 6 系列長に対する Holm 多重比較補正後も )。
圧縮ストリームと局所ウィンドウの分離により、遠方のノイズを適度に抽象化しつつ文脈を活用できていることが伺えます。
3. Needle-in-a-Haystack 長文想起評価
長大なテキストの途中に埋め込まれた 4 桁のパスキーを正確に想起できるかを検証しました(各系列長 15 試行)。
| 系列長 | Standard-150M 完全想起率 (一致桁) | AnchorMass-150M 完全想起率 (一致桁) | 正答数差 (全15試行) |
|---|---|---|---|
| 4K | 93.3% (14/15, 3.87桁) | 100.0% (15/15, 4.00桁) | AnchorMass が +1問 |
| 8K | 80.0% (12/15, 3.47桁) | 80.0% (12/15, 3.53桁) | 同数 |
| 16K | 66.7% (10/15, 3.13桁) | 86.7% (13/15, 3.73桁) | AnchorMass が +3問 |
| 32K (学習上限) | 46.7% (7/15, 2.13桁) | 86.7% (13/15, 3.73桁) | AnchorMass が +6問 |
| 64K (2倍外挿) | 6.7% (1/15, 0.53桁) | 33.3% (5/15, 1.87桁) | AnchorMass が +4問 |
| 128K / 256K | 0.0% (0/15) / 0.0% (0/15) | 6.7% (1/15) / 0.0% (0/15) | 両者ほぼ 0 に低下 |
16K から 32K トークンにおいて AnchorMass-150M は大幅に高い想起率(86.7% vs 46.7%)を維持しました。
また、8K トークンにおける 5 つの異なる質問書式(接頭辞あり・なし、言い換え、メモ形式、対話形式)の汎化評価(計 150 試行)では、AnchorMass-150M が 134 問(89.3%)、Standard-150M が 130 問(86.7%)と、未知の書式に対しても同等以上の想起精度を示しました。
4. 第2段階キャッシュ管理ポリシーの比較検証
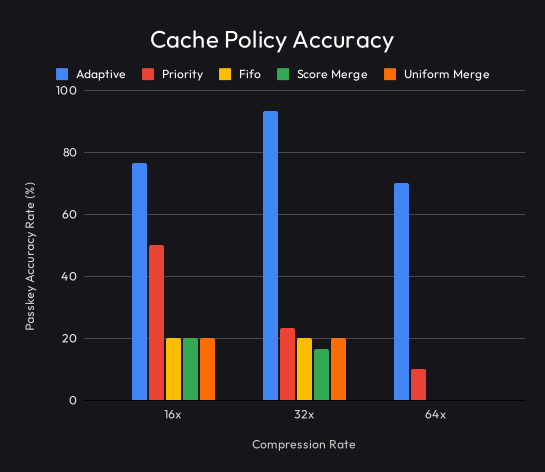
キャッシュ上限に達した際の再マージアルゴリズムとして、AnchorMass Attention に実装されている 5 つのポリシーを 8K トークン・極限圧縮条件下( 試行)で比較しました。
| キャッシュ予算 (圧縮率) | adaptive (提案手法) | score_merge | uniform_merge | priority (重要度選別) | fifo (先頭Sink+直近保持) |
|---|---|---|---|---|---|
| 512 slots (16倍圧縮) | 76.7% (23/30) | 20.0% (6/30) | 20.0% (6/30) | 50.0% (15/30) | 20.0% (6/30) |
| 256 slots (32倍圧縮) | 93.3% (28/30) | 16.7% (5/30) | 20.0% (6/30) | 23.3% (7/30) | 20.0% (6/30) |
| 128 slots (64倍圧縮) | 70.0% (21/30) | 0.0% (0/30) | 0.0% (0/30) | 10.0% (3/30) | 0.0% (0/30) |
なぜ adaptive だけが圧倒的に想起できるのか?
内訳を詳細に分析すると決定的な違いが判明しました。
fifo、score_merge、uniform_merge が正解できた問題は、すべてプロンプトの最末尾(深度 0.9)にパスキーがあった試行のみであり、中盤以前(深度 、全 24 試行)では 正答数が完全に 0 でした。
これに対し、先頭 Sink と直近領域を保護しつつ中間領域の低エネルギーペアを加重統合する adaptive は、中盤以前の深度でも 128 スロットで 16 勝(66.7%)、256 スロットで 22 勝(91.7%)と、過去の文脈を失わずに拾い上げることができました。
5. 短文常識推論(JCommonsenseQA 全1,119問)
長文特化の圧縮や SFT を施すことで、モデル本来の日本語常識推論能力が破壊されていないかを検証するため、JGLUE の JCommonsenseQA(全 1,119 問)を全学習ステージで横断評価しました。
| 学習ステージ | Standard-150M 正解率 | AnchorMass-150M 正解率 | 正解率差 | 厳密 McNemar 検定 |
|---|---|---|---|---|
| Stage 1: 1K 基礎事前学習 | 56.03% (627/1119) | 57.91% (648/1119) | +1.88pt | (有意差なし) |
| Stage 2: 4K Context Warmup | 54.96% (615/1119) | 57.37% (642/1119) | +2.41pt | (有意差なし) |
| Stage 3a: 32K 長文 SFT v2 | 52.73% (590/1119) | 57.37% (642/1119) | +4.65pt | (有意差あり) |
| Stage 3b: 短文 Chat SFT | 56.03% (627/1119) | 56.39% (631/1119) | +0.36pt | (有意差なし) |
Stage 1、2、3b では両者に統計的な有意差は見られませんでした。
しかし注目すべきは Stage 3a(32K長文SFT)後 です。Standard-150M が 52.73% へと性能低下を起こしたのに対し、AnchorMass-150M は 57.37% をキープし、+4.65 ポイントの有意差() を示しました。直近 64 トークンを無圧縮で処理する Local Head が、長文抽出ファインチューニング時における短文推論能力の破滅的忘却を防ぐ緩衝材として機能した可能性が考えられます。
見えてきたトレードオフと限界
ここまでの結果では AnchorMass は優れていますが、実際の運用においては明確な代償と未解決の課題が存在します。
1. Prefill 遅延と損益分岐点の現実
もっとも大きな代償は Prefill(プロンプト処理)時間の大幅な遅延 です。
一括 FlashAttention-2 を利用できる Standard-150M に対し、AnchorMass-150M は 1,024 トークン刻みのチャンク分割と Value 外れ値判定・加重平均処理を PyTorch 上で順次実行するため、Prefill が 3.6〜12 倍遅くなります(256K 時で Standard 10.18秒に対し AnchorMass 36.59秒)。
デコード速度では 128K・256K で AnchorMass が逆転しますが、Prefill の遅れを取り戻すための概算損益分岐点は、
- 128K トークン入力時: 約 1,036 トークン以上を生成して初めてトータル時間が逆転
- 256K トークン入力時: 約 603 トークン以上を生成して初めてトータル時間が逆転
となります。つまり、数十〜数百トークン程度の短い回答を出力するタスクでは、トータル実行時間は Standard-150M の方が圧倒的に高速 です。この遅延を解消するには、Triton 等によるブロック圧縮のカスタム融合カーネル開発が不可欠です。
2. RoPE テーブル拡張によるピーク VRAM の増加
「総 KV キャッシュが 258 MiB に固定される」とはいえ、プロセス全体の Peak VRAM は 256K 時に 4.95 GiB まで増加しました。
この最大の要因は、全 14 層の Attention レイヤーがそれぞれ独自に系列長 の FP32 RoPE テーブル(256K 時に単体で 1.75 GiB)を事前確保・保持しているためです。真の定数メモリ推論を実現するには、RoPE テーブルの層間共有やオンザフライ(都度計算)化が必要となります。
3. 64K 以降の想起率急減
Needle 想起テストにおいて、16K〜32K では高精度を誇ったものの、64K では 33.3%、128K 以降はほぼ 0% へと急落 しました。
これは、
- 32K までしか学習していない Dynamic NTK RoPE の外挿限界
- キャッシュ上限 8,192 スロットを超過したことで初めて発火する「第2段階キャッシュ再マージ」の累積誤差
の2つが複合した結果と考えられます。「256K の超長文でも OOM を起こさずに推論・デコードを実行できること」と、「256K 先の微細な情報を正確に想起できる有効コンテキスト長」は全くの別物 である点に注意が必要です。
4. 構成要素別アブレーションの未実施
今回の検証は AnchorMass Attention 全体を一括で有効化した比較にとどまっており、
- (a) Value 外れ値分離スロット
- (b) 背景加重平均とアンカー Key
- (c) 質量バイアス近似
- (d) Local / Global Head 分割比率
の各要素がそれぞれ何%の性能寄与を果たしているかの個別アブレーション実験は未完了です。
Outro
長文 LLM における KV キャッシュ爆発問題に対し、幾何学的外れ値の保護と質量保存、そしてエネルギー指標による段階的マージを組み合わせることで、150M パラメータモデルにおいて 256K トークンを実測 258.58 MiB の KV キャッシュで安定デコードできること を実証しました。
一方で、現状の実装パイプラインでは Prefill 遅延 や RoPE テーブルによる VRAM 消費、そして 64K 以降の想起限界 という現実的なトレードオフも浮き彫りになりました。
- この内容のリポジトリ: GitHub - rsu-Suba/AnchorMass-Attention
- この内容のHugging Faceリンク: Hugging Face - rsu/AnchorMass-Attention